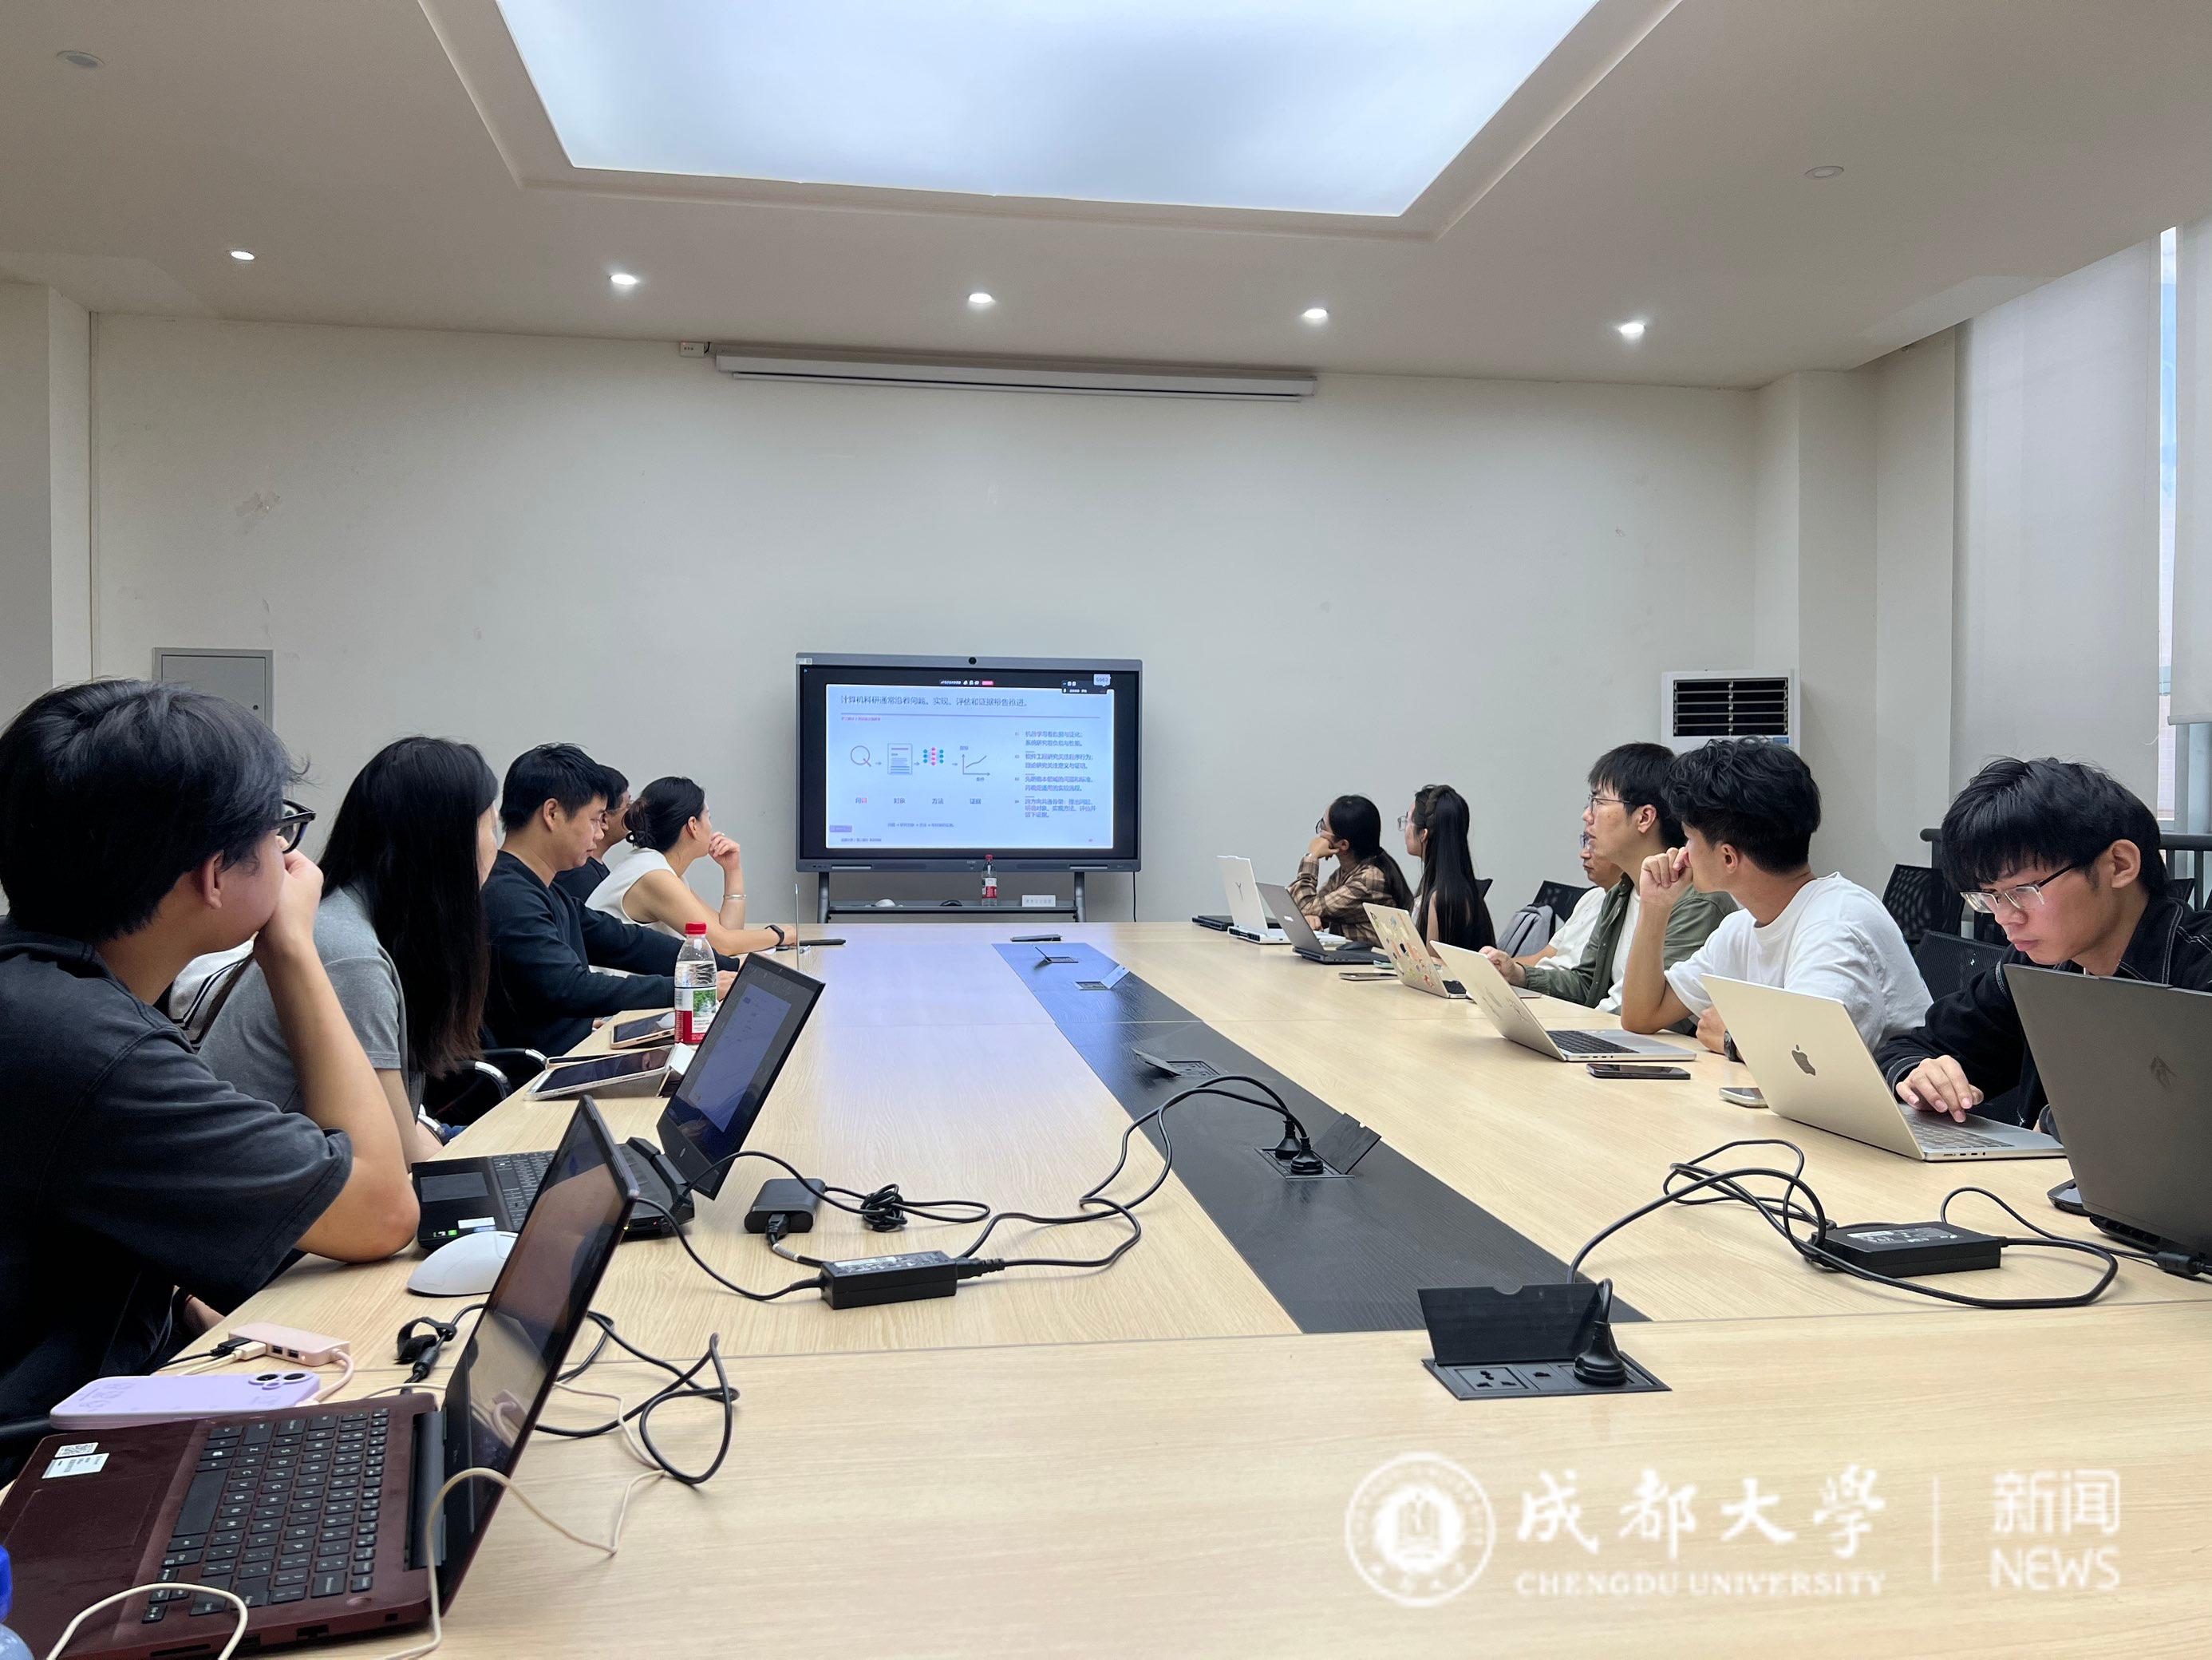
2026年9月30日下午2时30分,由计算机学院主办的“大模型赋能科研”专题分享会在学院10106会议室举行。本次分享会由罗旭主讲,围绕大语言模型在科研工作中的应用路径与实践方法展开,学院相关教师及学生到场聆听。
随着大语言模型技术的快速发展,人工智能正逐步渗透到科研选题、数据处理、实验设计与成果撰写的各个环节,科研工作的方式方法面临新的机遇与挑战。为帮助学院师生了解大模型工具的前沿进展,掌握规范、高效的使用方法,提升科研工作的质量与效率,学院组织举办了本次专题分享会。
分享会中,罗旭结合自身科研实践,从三个层面系统介绍了大模型在科研工作中的具体应用。
一是辅助数据分析。罗旭介绍了大模型在数据来源、数据分析与结果解读等环节的应用方式,指出在规范提示与合理约束下,大模型能够有效缩短数据处理周期,帮助科研人员将更多精力投入到问题本身。他进一步指出,在数据汇总、图表生成等科研基础工作中,大模型同样能够提供有力辅助,帮助科研人员从重复性、事务性工作中解放出来,将更多精力投入到科学问题的凝练与创新思考上。
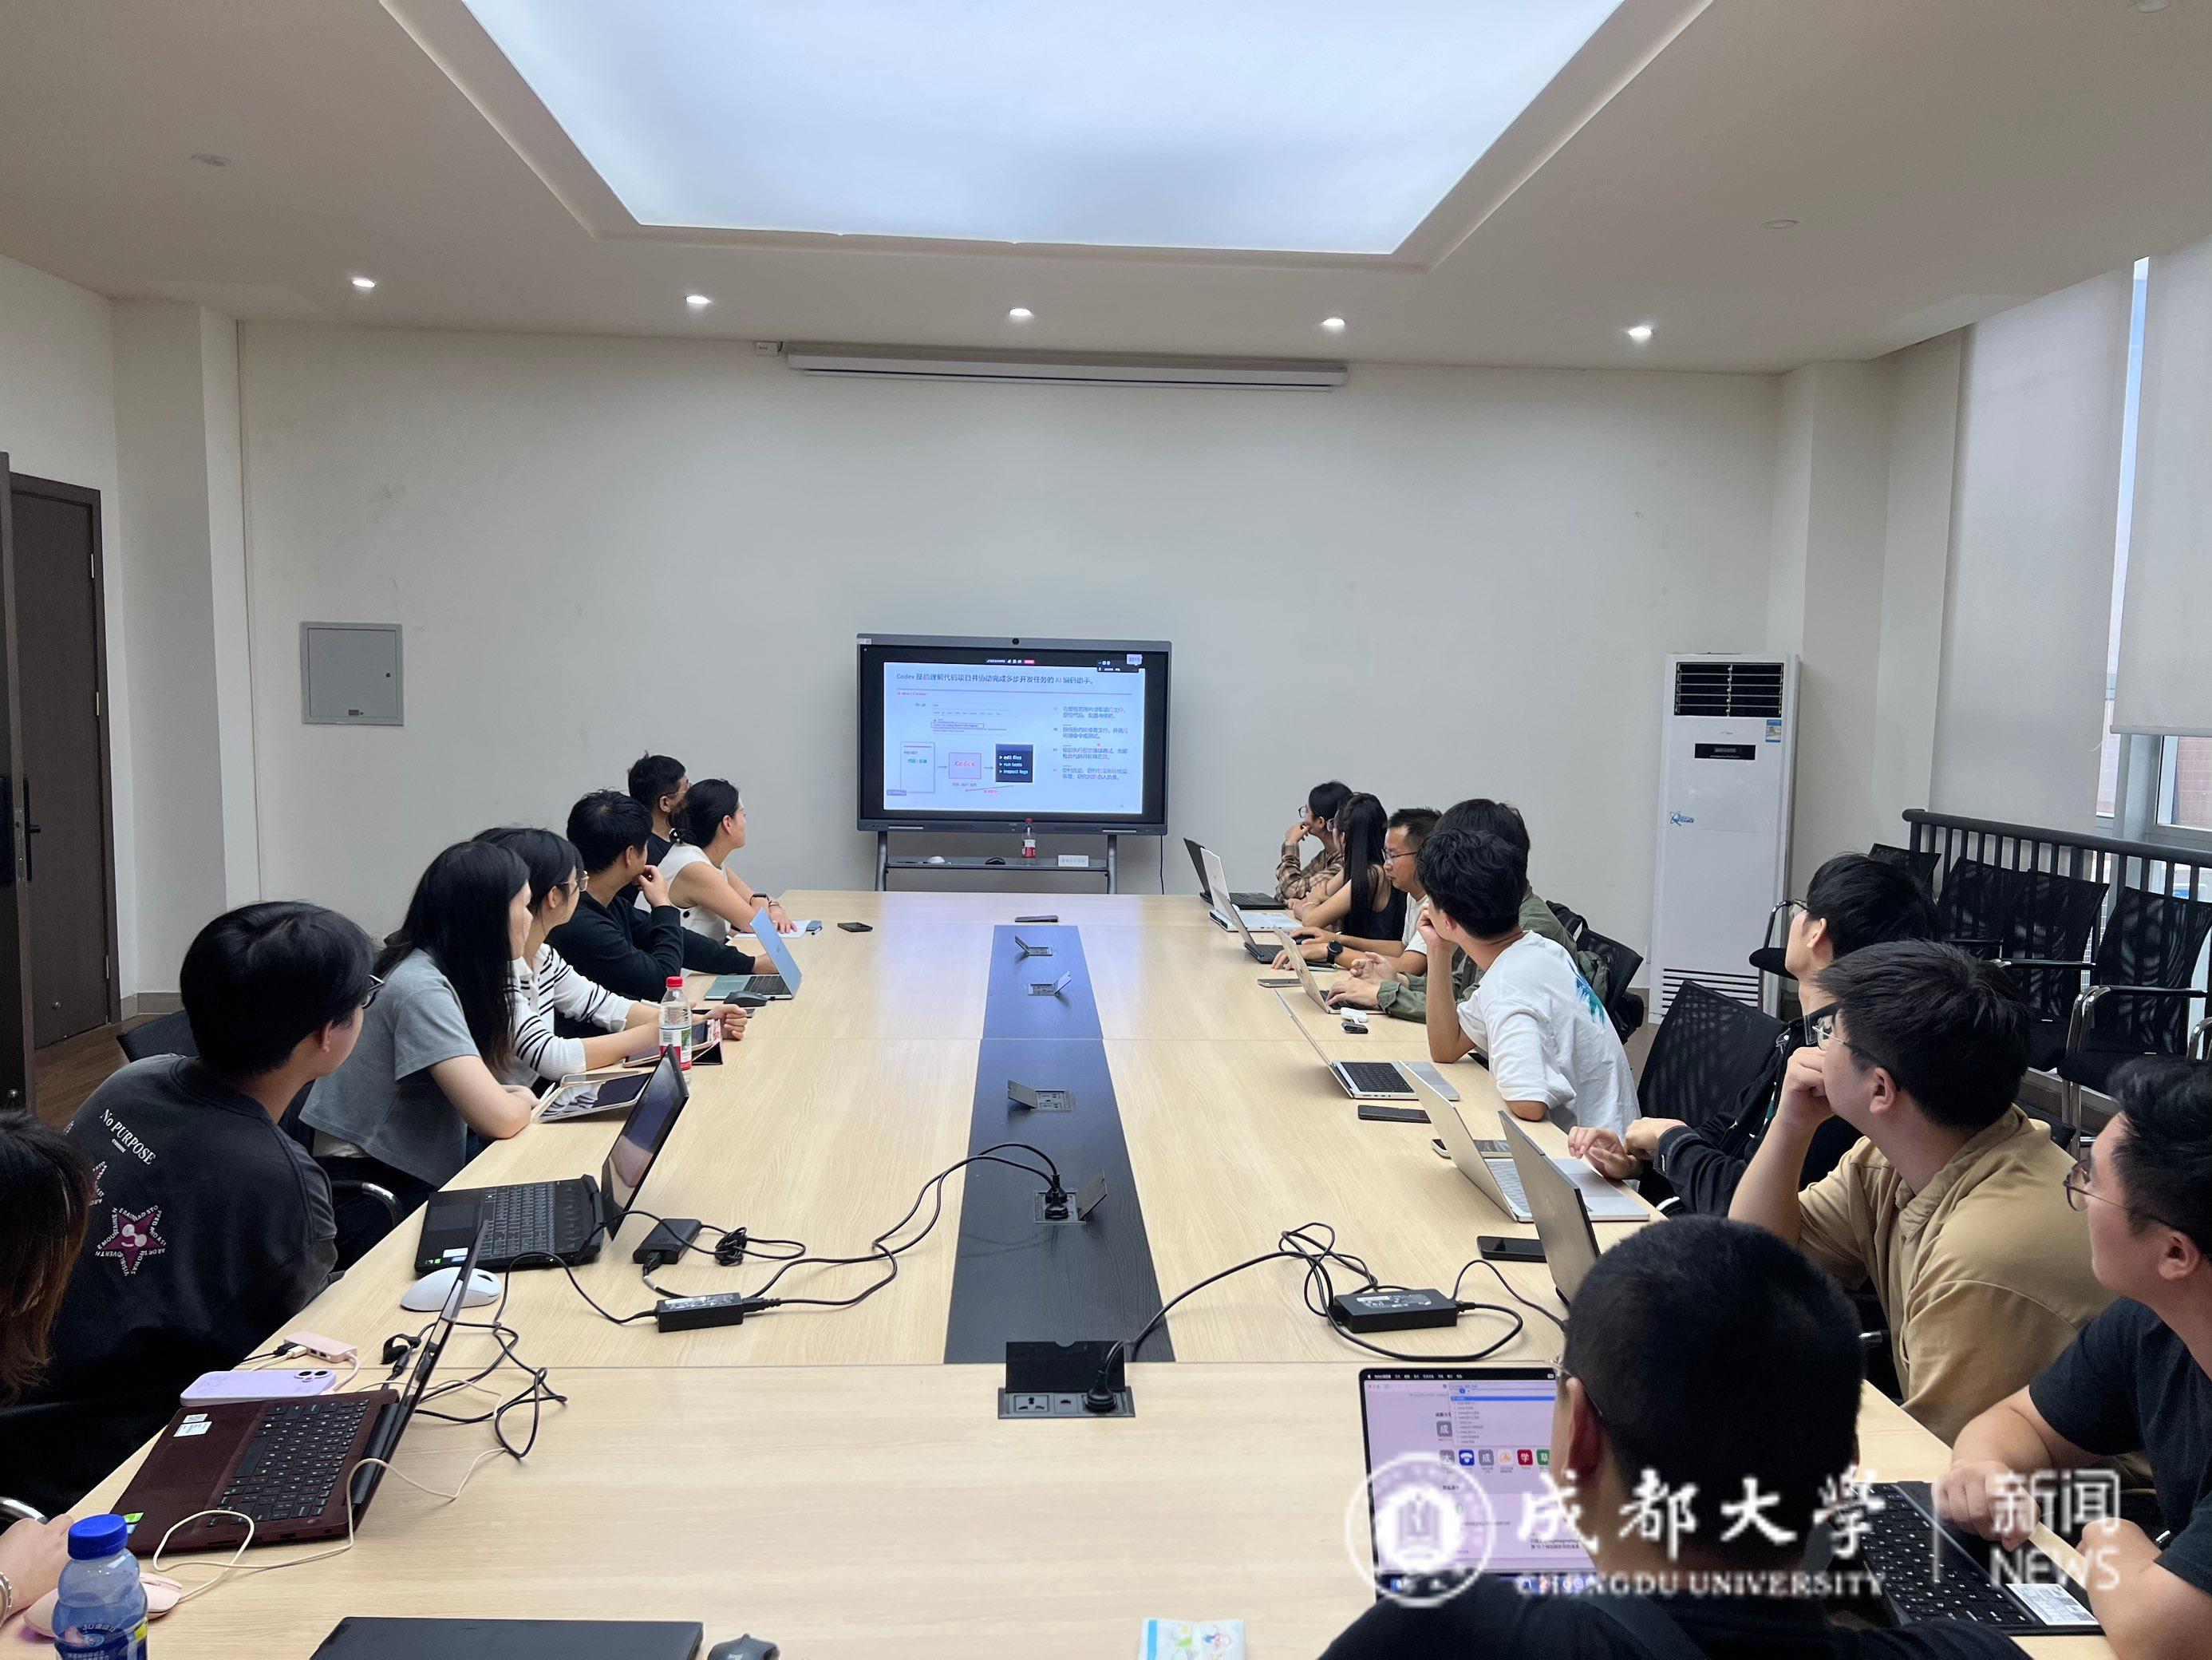
二是辅助环境搭建。针对科研工作中常见的开发环境配置、依赖管理与工具链部署等问题,罗旭介绍了借助智能体(agent)实现自动化部署的解决思路,即将环境配置流程、依赖安装规则与常见问题排查方法封装为可复用的智能体任务,由智能体自动完成配置解析、依赖装配、脚本生成与错误修复,减少人工反复调试成本。他强调了版本固定、可复现配置的重要性,指出基于智能体的部署方式有助于沉淀标准化、可迁移的科研环境,为团队协作与成果复现提供支撑。
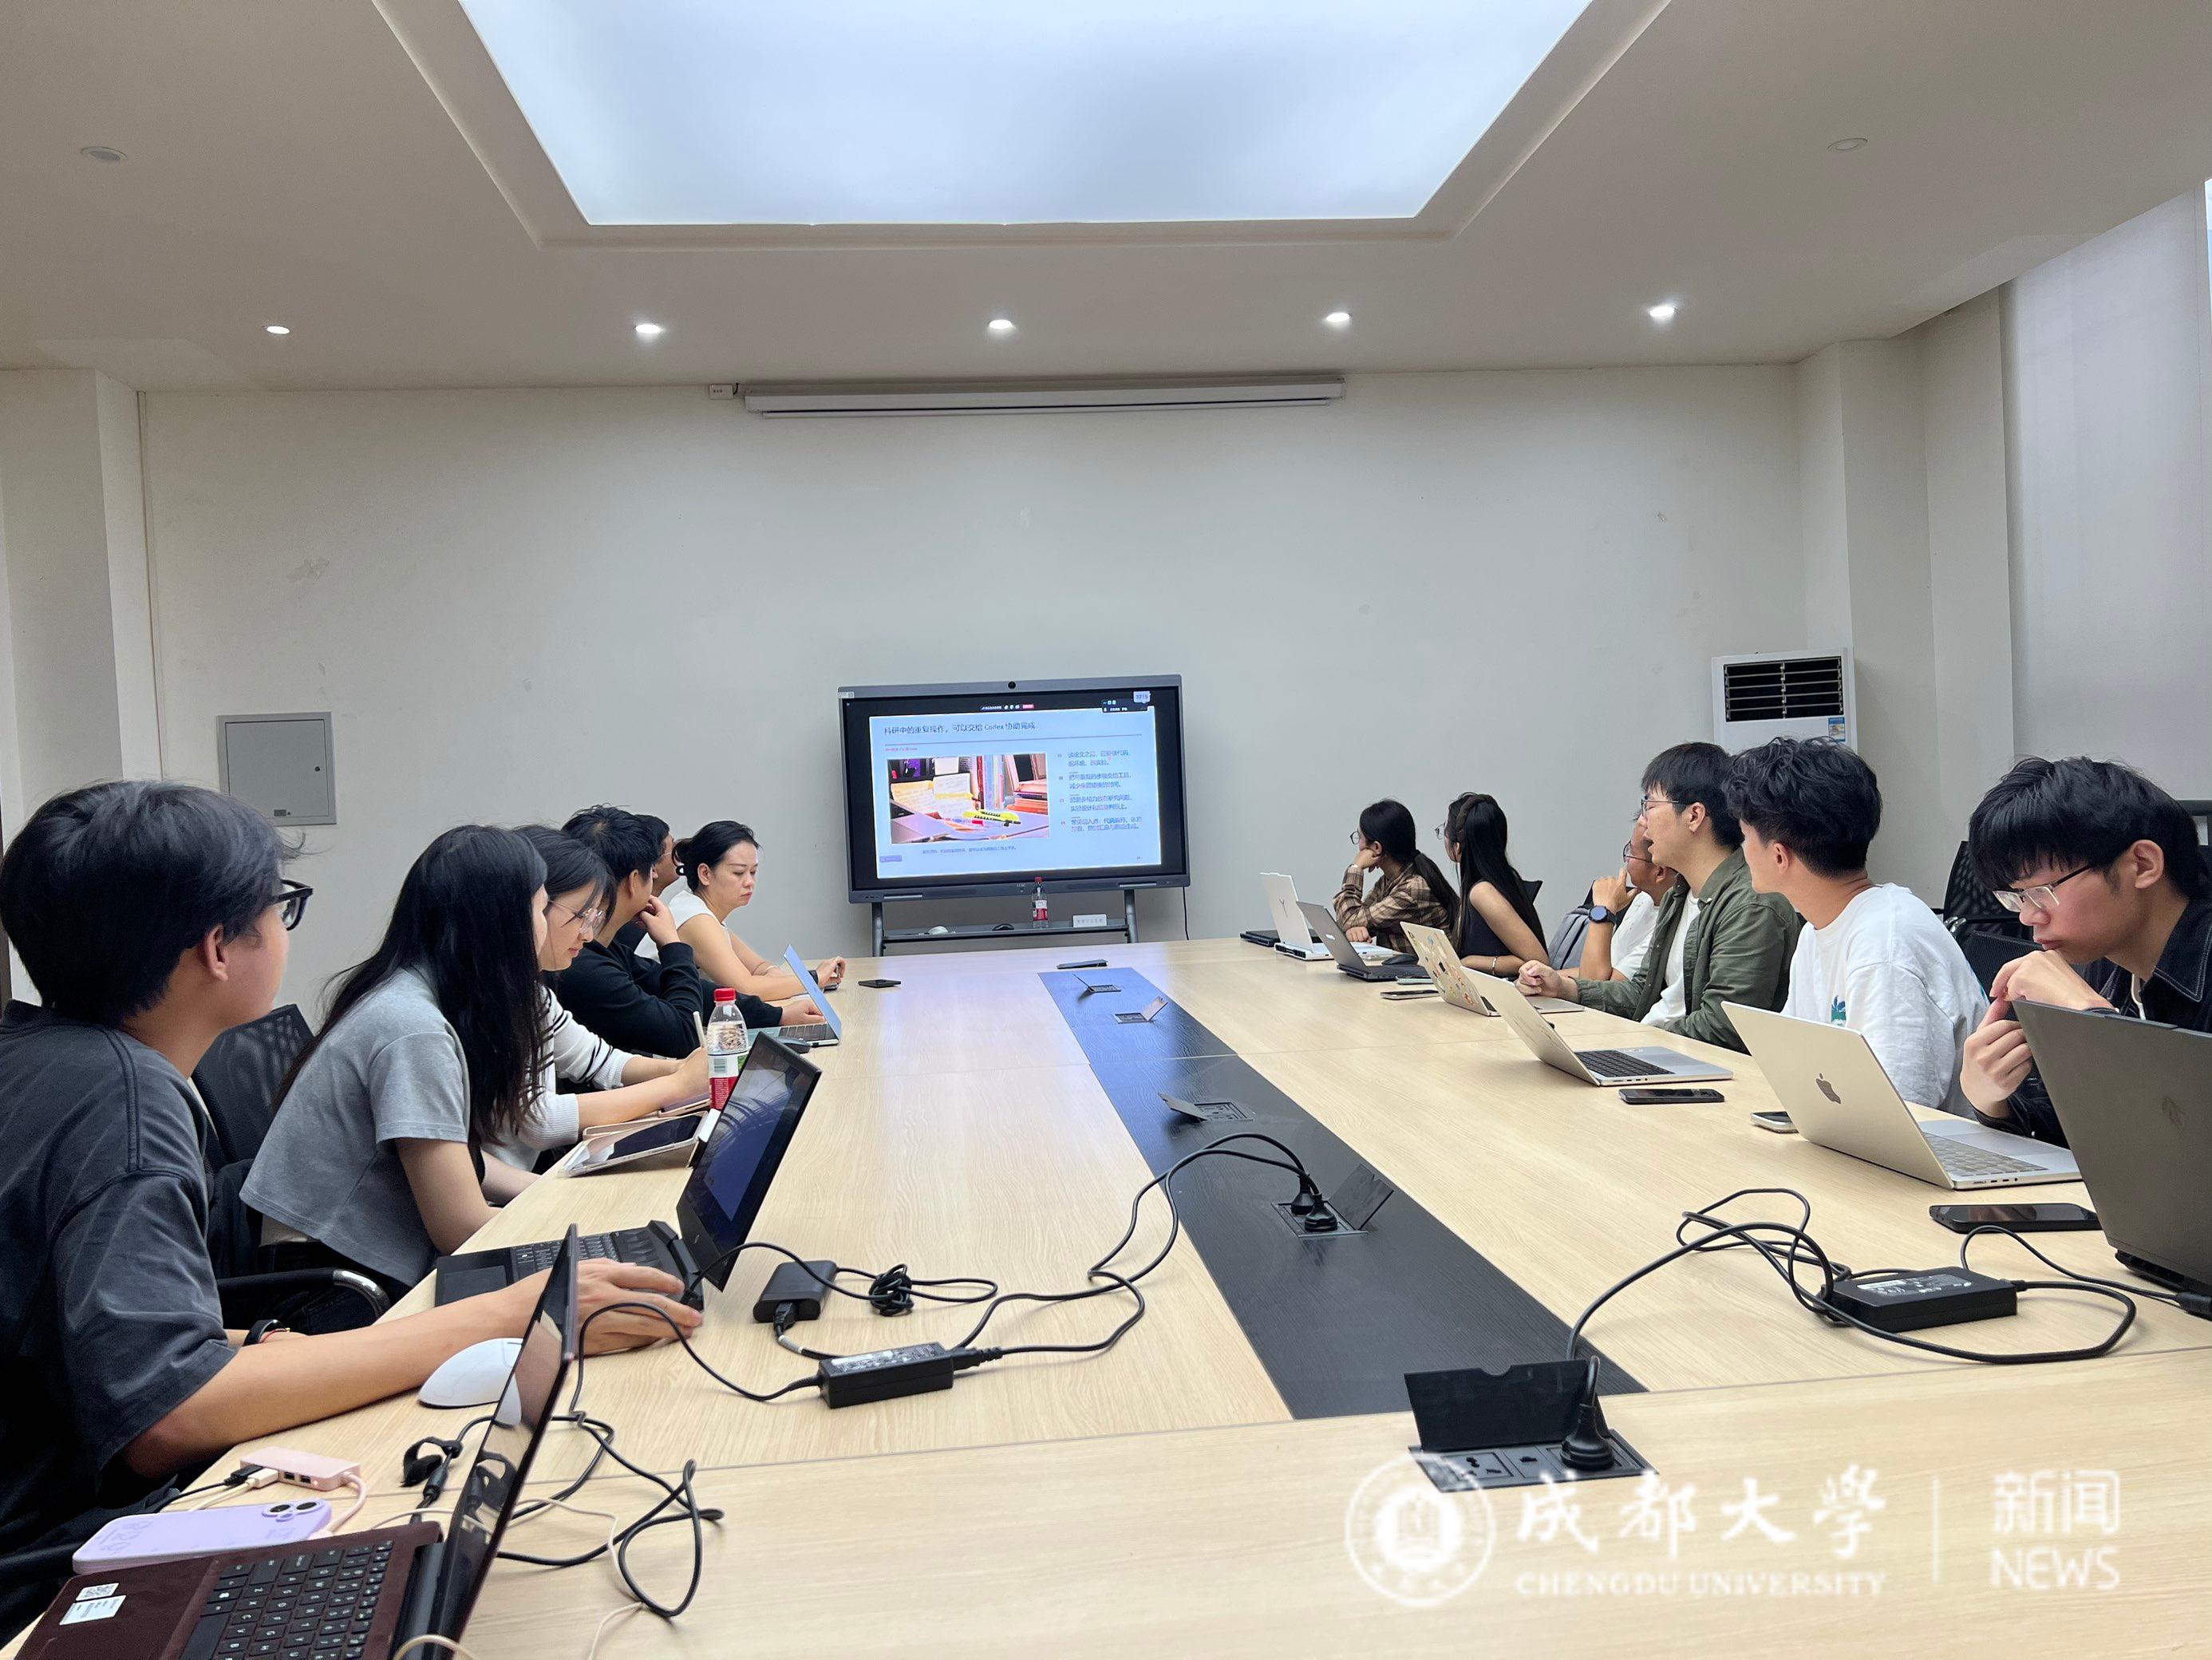
三是辅助代码撰写。罗旭介绍了大模型在代码生成、调试与优化中的辅助作用,同时提醒师生应坚持人工复核,确保代码的正确性与可维护性。他进一步指出,科研中的读代码、代码编程等环节都可以交给大模型协同完成,从而帮助科研人员更高效地完成科研基础工作,让科研人员能够更高效地聚焦于关键科学问题。
结合上述内容,罗旭总结提出了一套“聚焦问题、明确对象、选择方法、夯实证据”的科研工作流。他指出,大模型并非替代科研人员的思考,而是作为一种高效工具,帮助科研人员完成重复性、规范性工作;科研人员应在明确研究目标的基础上,将复杂问题拆解为可验证的子任务,通过多轮对话逐步逼近问题的最优解,并始终保持对结果的独立判断与严格验证。
本次分享会内容详实、案例丰富,为学院师生了解大模型辅助科研的前沿动态与实践方法提供了有益参考,对学院进一步推动人工智能与科研工作的深度融合具有积极意义。